SPA (Static Program Analysis)

静态程序分析(Static Program Analysis, SPA)的目标很明确:在不实际运行程序的前提下,仅通过源代码获取部分我们感兴趣的程序信息。 例如:
- 这个变量是否被使用过?
- 这个表达式的计算结果是否一定是常量?
一般而言,我们可以针对这些具体问题,朴素地编写一些特定的分析代码来达成目标。而研究 SPA 的意义主要在于:
- 提供一套通用的方法和套路,指导我们按照固定的流程完成分析目标。
- 提供一套完整的术语体系和理论论证,证明上述方法的有效性,或者明确其适用范围。
程序分析在逻辑上并不十分复杂。对于静态程序分析而言,重点主要是分析速度要快。如果静态分析的耗时甚至超过实际运行一遍程序,那么几乎可以认为这种分析是不可用的。
基础术语
Sound & Complete
假定所有在运行期可能出现的结论共同构成一个 Truth 集合,其中的结论都被称为 Correct。
在静态分析中,有两个重要概念:Sound 和 Complete,可以简单理解为“保全”和“保真”。
- Sound(保全,Over-approximate):分析结果集合包含所有 Correct 的结论。
- Complete(保真,Under-approximate):分析结果集合中的所有结论都是 Correct 的。
- Sound & Complete:分析结果集合既包含所有 Correct 的结论,同时也不包含任何不正确的结论。
莱斯定理(Rice's Theorem):不存在一个通用的判定器,能够完美地判定程序的 Non-trivial 属性。换言之,不存在一个通用的、同时满足 Sound 和 Complete 的程序语义属性判定器。
Trivial 属性是指所有递归可枚举语言(Recursively Enumerable Languages)都满足,或者都不满足的属性。通俗地近似理解,任何必须在运行期才能获得具体结果的程序属性,都可以看作 Non-trivial 属性。
这一定理告诉我们,不应该期望实现一个通用且完美的静态程序分析器。但对于特定任务,如果有足够的已知信息或约束条件,仍然可能实现一个同时满足 Sound 和 Complete 的分析器。
在实践中,我们一般需要做出一定妥协,而妥协的目标只有一个:保证分析结果对我们而言是有意义的。具体而言,我们将这种有意义的分析结果称为 Safe。
一个直观的例子是判断“指针是否为 nullptr”。
显然,对于一般程序中的这一问题,我们无法同时保证 Sound 和 Complete,因为总有一部分指针的取值只有在运行期才能确定,例如通过 main 函数入口由用户传入的值。
莱斯定理可以借助图灵机停机问题来反证:如果希望获得程序的所有属性,首先需要判断某条语句stmt是否会被执行。如果该语句不会被执行,那么它自然不会贡献任何信息。而判断stmt是否会被执行,本质上就涉及判断stmt之前的程序是否会停机。
Dataflow Analysis
Dataflow Analysis 是一类程序分析方法的统称。
从形式上来说,只要分析结果被记录在某种 State 中,并且这个 State 能够沿着 IR 结构进行逻辑上的更新,就可以将其称为 Dataflow Analysis。
宽泛地说,常用的程序分析几乎都可以视为某种 Dataflow Analysis。
其中,Pointer Analysis 通常是较为复杂的一类分析。粗略地说,指针分析的目标是:对于给定的 Program Point,分析该位置处指针ptr可能指向的 Object。
Dataflow Analysis 中涉及的主要概念如下。
State
State 用于存储分析过程中获得的信息。
- State 的值域通常记作 V,称为 Domain。在正式的研究中,会进一步使用 Lattice 来描述值域。
- State 通常涉及 Top 和 Bottom 两种特殊状态(Lattice 中的术语):
- Top(\top):通常表示可能处于任意状态,即全集。
- Bottom(\bot):通常表示没有任何信息,即空集。
- Top(\top):通常表示可能处于任意状态,即全集。
PP(Program Point)
Program Point 对应 IR 中的某个元素,用于关联和存储 State。
根据 PP 绑定的对象不同,可以将分析划分为两类:
- Dense Analysis
- PP 可以与 Instruction、Operation 或 Basic Block(BB)绑定,用于描述某个程序位置上的信息。
- 这类分析通常需要沿着指令流逐条分析,才能获得最终结果。
- PP 可以与 Instruction、Operation 或 Basic Block(BB)绑定,用于描述某个程序位置上的信息。
- Sparse Analysis
- PP 可以与 Value 绑定,用于描述某个值的相关信息。
- 这类分析通常只需要沿着 Def-Use Chain 进行传播,可以跳过中间大量无关的指令。
- PP 可以与 Value 绑定,用于描述某个值的相关信息。
Sensitive
Sensitive 用于描述分析对不同程序执行特征的敏感程度,主要包括以下几类:
- Flow-sensitive
- 关注 PP 之前的指令应当被视为有序序列,还是无序集合。
- Flow-insensitive 意味着不关心指令的执行顺序,先处理哪条指令都可以。
- 关注 PP 之前的指令应当被视为有序序列,还是无序集合。
- Path-sensitive
- 关注当多条执行路径到达同一个 PP 时,如何处理不同路径上的信息。
- Path-sensitive 需要为不同路径维护不同的分析结果。
- Path-insensitive 则需要在控制流汇聚处合并来自不同路径的信息。
- 关注当多条执行路径到达同一个 PP 时,如何处理不同路径上的信息。
- Context-sensitive
- 关注当执行路径跨越函数边界时,如何处理来自不同函数调用上下文的信息。
- 这一概念与 Path-sensitive 类似,只不过关注的是跨函数的调用上下文。
- 关注当执行路径跨越函数边界时,如何处理来自不同函数调用上下文的信息。
Dataflow Analysis 的执行流程
Dataflow Analysis 的一个重要特点是:分析过程高度模式化,并且有系统的Lattice理论论证来说明其性质。
一般而言,Dataflow Analysis 的执行流程类似于使用一个简单的解释器来执行代码。
我们为每条指令定义一个简单的 State 处理函数,称为 Transfer Function。它根据流入当前指令的信息,计算出执行该指令后的新信息。
典型的分析流程如下:
- 初始化 State
- 为所有需要分析的位置关联一个 PP,并初始化对应的 State。
- 为所有需要分析的位置关联一个 PP,并初始化对应的 State。
- 遍历 IR,更新 State
- 从 Entry Point 出发,沿着指令流方向遍历整个 IR,并更新相关 State。
- 如果沿着指令流遍历,对应 Dense Analysis;如果沿着 Def-Use Chain 传播,则对应 Sparse Analysis。
- 分析也可以沿着指令流(或 Def-Use Chain)的反方向进行,这种方式称为 Backward Analysis。
- 从 Entry Point 出发,沿着指令流方向遍历整个 IR,并更新相关 State。
- 重复分析,直到 State 不再变化
- 只要某个 PP 的 State 发生变化,就需要重新执行分析,确保可能受其影响的PP被更新。
- 在满足一定条件时(这个条件比较宽松, 一般都可以满足),可以从理论上证明:无论从哪个点开始遍历,或者在什么时机重新开始遍历,都不会影响算法最终的收敛结果。
- 实际开发中,通常使用 Worklist 策略维护待遍历节点。其基本原则是:只要
foo.state发生变化,所有可能受foo影响的 PP 都需要重新加入 Worklist,等待再次分析。
- 只要某个 PP 的 State 发生变化,就需要重新执行分析,确保可能受其影响的PP被更新。
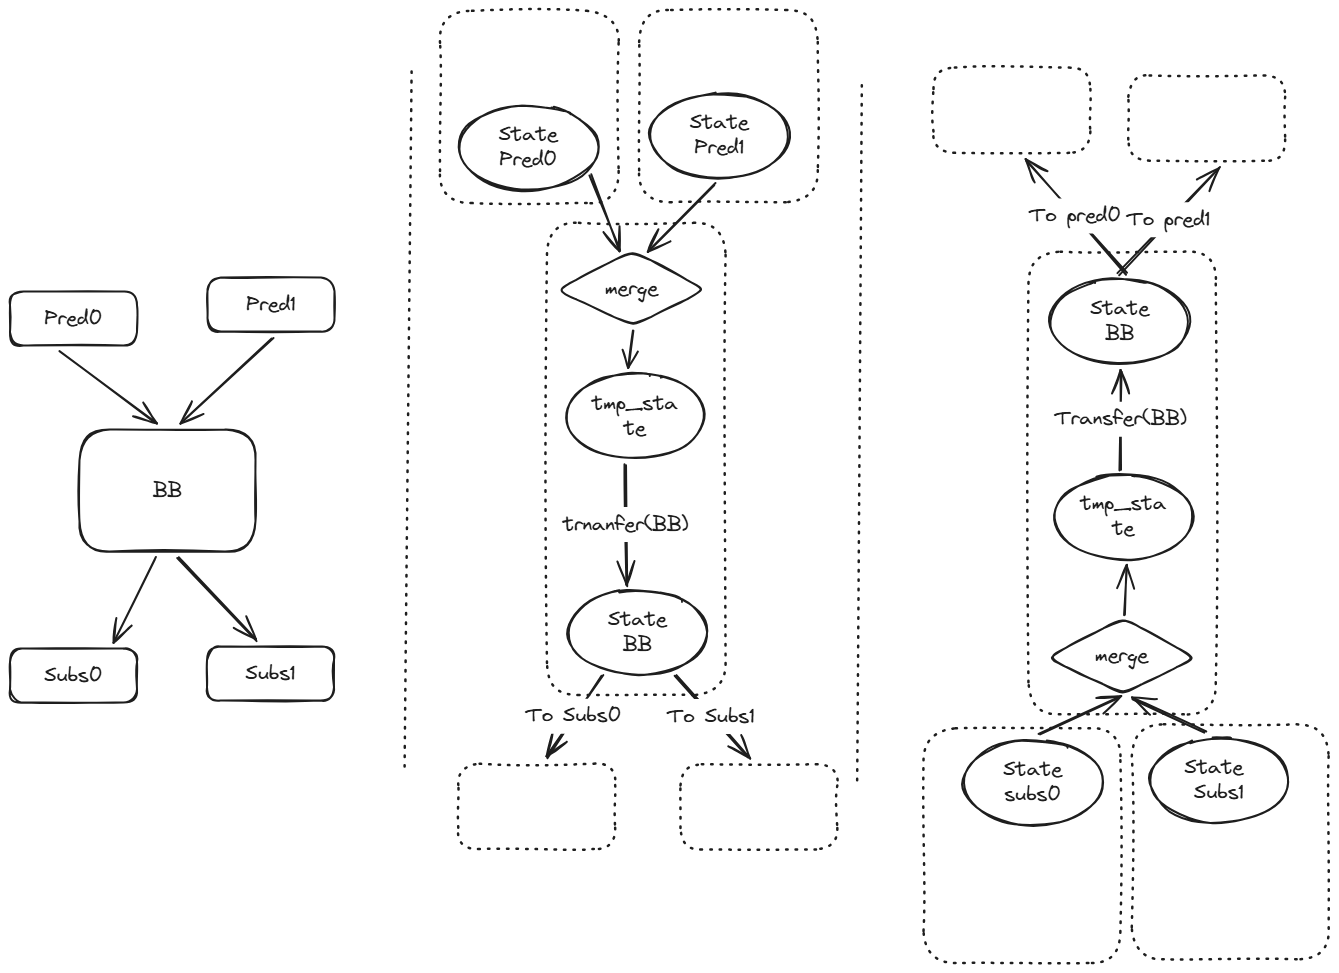
如果采用以 BB 为单位的方式组织 State,那么 State 构成的图在整体结构上与 CFG 基本一致。
下面的虚线框描述了如何根据其他 BB 的 State 计算当前 BB 的 State。由于这里需要处理来自不同执行路径的信息,因此还需要通过 Merge 操作合并不同路径上的分析结果。