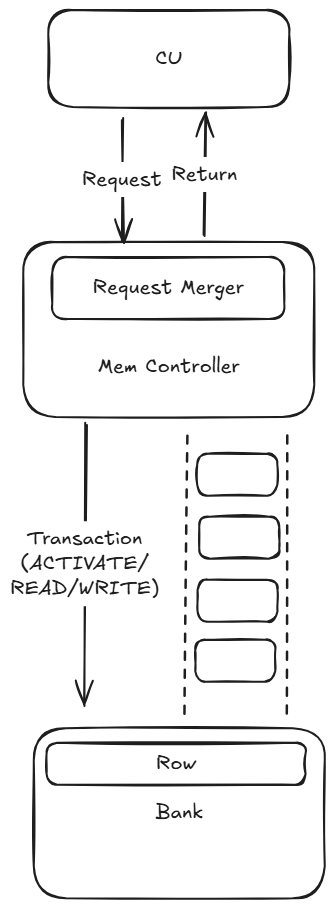
内存心智模型

若忽略 Cache 的存在:

  • 从 Guest 的视角来看,Guest 负责发出 Request(Load/Store 指令),Memory Controller 则在数据 Ready 时通知 Guest。

- Request 通常不会立即得到响应。Memory Controller 会先对请求进行合并,再统一处理。

- Memory Controller 会向物理内存发起 ACTIVATE / READ / WRITE 等操作。每次硬件数据传输都对应某个 Bank 中的 Row。Memory Controller 需要先执行 ACTIVATE,才能进行 READ / WRITE,而 ACTIVATE 通常非常耗时。

  • 硬件的单次 READ / WRITE 操作总有一个最小传输 Size,即使实际需要的数据量小于该 Size,也必须按照最小传输粒度执行。
  • 当已知 Latency 和 Bandwidth 时,可以将 READ / WRITE 抽象为在一条宽度为 Bandwidth、长度为 Latency 的传送带上传输数据。这条传送带可以称为 Channel。

- 一个系统中可以存在多个 Channel,并行执行数据传输。

  • 这一模型与 Little's Law 相对应。传送带可以类比为排队论中的队列:为了保证传送带始终满载,需要让队列中始终保持足够数量的待处理请求。

Read more

The Building Blocks of Transformers

Transformer(Attention Is All You Need)最初作为翻译模型出现,并极大地影响了后续深度学习(DL)领域的研究热点。 相比传统的 RNN,Transformer 具有以下特点: 1. 消除了时间维度上的顺序计算依赖:在训练阶段及推理的 Prefill 阶段,不需要沿时间维度依次处理输入中的每个时间点。一方面避免了计算的顺序依赖,另一方面减少了动态控制流,从而极大地提升了计算效率。 1. 计算结构简单:Transformer 使用的基本计算单元非常简单,几乎只有 GEMM、+ - * / 和 Softmax,单个Block内没有复杂的计算流程,整体架构是对基础Block的不断重复,因此,原论文的作者将其称为一个“简单”的模型。 本文不关注训练、推理等 LLM 相关业务,而是重点介绍 Transformer 中典型的基本计算单元,包括它们的逻辑功能与计算方法。 为了简化内容,本文仅关注现代 LLM(2023

By Edimetia3D

Coroutine

从一般概念上说, 协程是特殊的函数调用: 被调用的函数可以在可控的位置被中断,然后在下一次调用时,继续从上次中断的位置继续执行。 本文主要通过Python的协程来介绍协程, 这是我唯一熟悉的一种协程实现. Classic Coroutine 下面的python代码很好的说明了协程的核心功能 def co_routine(): recv0 = yield 996 # hangs here after first coro.send assert recv0 == "Second" yield 711 # hangs here after second coro.send return def main(): coro = co_routine() # Create a new coroutine object value = coro.send(None)

By Edimetia3D

GDB with Python

这篇文章的主要应用场景是调试Python的C/C++ Extension 1. 同时使用pdb / gdb 进行调试. 通俗点说, 既可以break在 .py 文件中,也可以break在 .cc 文件中 2. 在gdb中不但可以获得常规的调试信息, 还可以获得python VM 的调试信息, 例如获得python的调用栈, 访问Python局部变量等. 这将会在调试exception时(如Segmentfalut)非常有用, 这种场景下, 定位 Python VM 正运行到哪一行代码往往可以提供一些直观的重要信息. 第一步: 编译源码以获得一些辅助数据. 我们并不真的需要使用从源码编译的Python, 但是一些调试相关的辅助文件需要从源码中获得, 包括 python-gdb.py及debug symbol等. 在 https://www.python.org/ftp/python/ 或 https://github.com/python/cpython

By Edimetia3D