CUDA Branch Divergence

Background
CUDA 的 SIMT(Single Instruction, Multiple Thread)模型为程序员提供了“每个 Thread 独立执行标量程序”的语义。在实际执行时,为了提高效率,硬件会尽量让同一个 Warp 内的 32 个 Lanes 执行相同的指令。
当同一个 Warp 内的 Threads 进入不同的控制流路径时,就会发生 Branch Divergence。CUDA 通过编译器与硬件配合,利用 Active Mask、Predication、Reconvergence 等机制处理这一问题。
可以将 CUDA 的 SIMT 理解为:在 SIMD 硬件的基础上,模拟出每个 Thread 都拥有独立控制流的执行效果。
传统 SIMD 硬件已经支持使用 Predicate/Mask 进行简单的条件控制,即通过 Mask 屏蔽特定 Lane,使指令只对部分数据生效。但仅依赖这种 Mask 机制,无法直接实现通用的 Conditional Branch 控制流。CUDA 的 SIMT 则在 SIMD 执行模式的基础上增加了控制流支持。
Post Dominator 与 Convergence Point
Post Dominator(后支配节点) 是实现 SIMT 控制流时涉及的一项重要编译期分析。
对于一个 Basic Block(BB),如果从该 BB 出发,无论后续沿哪条路径执行,最终都必然经过另一个 BB2,那么 BB2 就是 BB 的 Post Dominator。
需要注意以下两点:
- 从 BB 出发的执行路径一定会经过它的 Post Dominator BB。
- 到达同一个 Post Dominator BB 的路径可能不止一条。
在 CUDA 中,当编译器决定使用 Branch Divergence 实现控制流时,通常会将 Branch 指令所在 BB 的第一个 Post Dominator(Immediate Post-Dominator)对应的指令地址作为该 Branch 的 Convergence Point(汇合点)。
当控制流比较简单时,编译器和硬件有多种方式处理 Branch 指令,并不一定需要使用 Convergence Point。
Pre-Volta
注意: 本节描述的是 Volta 之前 CUDA 架构的特性。尽管这些描述已经不完全适用于 Volta 及后续架构,但对于部分第三方 GPGPU 硬件而言,这种实现方式仍具有参考价值。
Branch Divergence 的执行流程
在 Pre-Volta 架构中,遇到 Branch 指令时,可以将执行过程大致近似为:
- 一个 Warp 共享一个 PC(Program Counter) 和一个 Active Mask。
- 遇到 Data-Dependent Conditional Branch 时,对所有 Active Lanes 计算对应的 Predicate。
- 如果所有 Active Lanes 的 Predicate 结果相同,则该 Branch 对整个 Warp 而言是 Uniform 的,只需要执行其中一条路径。
- 如果发生 Divergence,则硬件和编译器会将不同的执行路径表示为若干
{PC, active_mask, reconvergence_PC}状态。 - Warp 选择其中一条路径执行,其余路径则暂时保存在 Reconvergence Stack 中。
- 当前路径到达 Reconvergence Marker / Sync Point 后,如果仍有 Pending Path,则从 Stack 中恢复对应的 PC 和 Active Mask,继续执行下一条路径。
- 当所有路径都到达 Reconvergence Point 后,恢复原始 Active Mask,Warp 继续执行汇合后的代码。
显然,上述执行过程的实际效果相当于 True Branch 和 False Branch 都被完整执行一遍,只是各自使用不同的 Active Mask。
这种方式通常会降低执行效率,但在逻辑上实现了 SIMT 所要求的独立线程控制流语义。
实际实现中还会包含许多优化,尽可能避免不必要的路径切换,并尽早尝试跳转到 Convergence Point。
例如,当硬件准备跳转到 False Branch 时,如果发现mask & ~cond == 0,说明当前没有任何 Active Lane 需要执行 False Branch,因此可以直接继续执行,而不必进行这次跳转。
编译器与硬件的协作
上述机制依赖编译器和硬件的配合:
- 编译器: 在编译期通过 Post Dominator 分析,为需要处理 Divergence 的 Branch 指令确定 Convergence Point。
- 硬件: 需要维护一个 Stack,用于保存尚未执行的路径及其相关执行状态。
Independent Thread Scheduling(Volta)
背景
Pre-Volta 的实现存在一个潜在问题:True Branch 和 False Branch 实际上会被串行执行,这可能降低实际的并发水平,进而影响硬件利用率。
例如,假设 A() 和 B() 使用完全不同的硬件执行单元:
A()使用 SFU。B()使用 ALU。
if (cond) {
    A();
} else {
    B();
}
理论上,当执行 A() 中的指令遇到 Idle 或 Stall 时,硬件完全可以尝试 Issue B() 中的指令,从而提高硬件资源利用率。
Pre-Volta 的实现难以做到这一点,主要是因为传统 SIMD 设计中,同一个 Warp 内所有 Lanes 共享一个 PC。
Independent Thread Scheduling 的基本思想
为了解决这一问题,从 Volta 开始,CUDA 引入了 Independent Thread Scheduling(ITS),采用了新的 Branch Divergence 处理机制。
从逻辑上看,CUDA 为每个 Lane 都维护了独立的 PC,使每个 Thread 能够独立推进自己的控制流。
理论上,这可以完全模拟传统标量程序的执行方式。
例如,对于 lane i,可以:
- 将 Active Mask 设置为
0x1 << i。 - 按照该 Lane 的控制流正常更新 PC。
- 执行完该 Lane 的所有代码,保证
lane i的结果正确。 - 对 32 个 Lanes 重复上述过程,即可保证所有 Lanes 的结果正确。
下图比较直观地展示了 Volta 前后的执行行为。
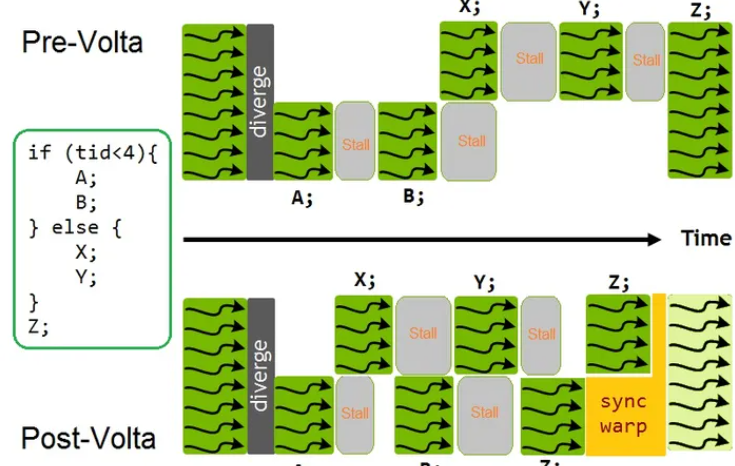
显然,让 SIMD 执行单元为每个 Lane 分别执行一遍程序,在性能上是不可接受的。
因此,Post-Volta 控制流实现的核心思想可以概括为:
独立维护 PC + 聚合执行(Grouping / Coalescing Execution)
聚合执行
聚合执行的基本思想是:在每次尝试 Dispatch 指令时,硬件先检查各个 Lane 的 PC,并尝试将 PC 相同的 Lanes 聚合到一起执行。
可以将这一过程近似理解为:
- 统计所有 Lanes 的 PC,选出 PC 相同的 Lanes,形成候选集合
{lane_issue}。 - 读取对应 PC 的指令,将 Active Mask 设置为
{lane_issue},然后 Issue 该指令。 - 更新
{lane_issue}中各个 Lane 的 PC:- 普通指令: 通常只需要将对应 Lane 的 PC 更新为下一条指令地址。
- Conditional Branch 指令:
- 将
cond & activemask对应 Lanes 的 PC 更新为 Target Address。 - 将
~cond & activemask对应 Lanes 的 PC 更新为下一条指令地址。
- 将
- 普通指令: 通常只需要将对应 Lane 的 PC 更新为下一条指令地址。
通过这种方式,同一个 Warp 内的 Lanes 在逻辑上可以独立推进,同时硬件仍然能够将执行相同指令的 Lanes 聚合起来,利用 SIMD 执行单元提高吞吐量。
聚合执行的优化
针对这种聚合执行机制,CUDA 会通过编译器与硬件的配合,尽可能保证每次取指令时,都有更多 Lanes 使用相同的 PC。
这样可以降低指令 Issue 次数,减少硬件执行资源的浪费。
已知的优化方向包括:
- 在编译期分析得到的某些固定位置尝试执行 Sync,将相关 Lanes 重新聚合到相同的 PC。
- 底层硬件尽可能高效地处理 Active Mask 不满的情况。
Post-Volta 的主要变化
Post-Volta 的一个重要特点是:
**active_mask** 不再必然与程序逻辑上的 Mask 一致。
从逻辑上看,每个 Lane 都可以独立向前推进自己的控制流。
进一步来说,即使程序已经执行到了看起来应该汇合的位置,实际的 Active Mask 也不一定是 0xFFFFFFFF。
这意味着,程序员不能再默认同一个 Warp 内的所有 Threads 始终以 Lockstep 的方式执行。
Warp-Level Synchronization
为了应对上述变化,CUDA 引入了 __syncwarp(mask),以及一系列 __xxx_sync(..., mask) 形式的 Warp-Level API。
这些 API 可以显式指定参与同步或集体操作的 Lanes。
可以将其近似理解为依赖每个 Warp 私有的 Warp Sync Register,其工作过程如下:
- 将指定的 Mask 写入 Sync Register。
- 当某个 Lane 到达对应的 Sync 调用时,清除 Sync Register 中该 Lane 对应的 Bit,并阻止 Dispatcher 继续调度该 Lane 的后续指令。
- 当 Sync Register 中所有相关 Bit 都被清除,即 Mask 变为 0 时,释放等待的 Lanes,或者执行对应的集体操作。
- 同步过程还附带 Memory Fence / Memory Ordering 效果,保证参与同步的 Threads 在同步前后的相关内存访问满足必要的顺序约束。
注意: 对于需要所有指定 Lanes 共同参与的 Warp-Level 操作,应该使用 __xxx_sync 系列 API,以保证 Mask 指定的 Threads 按要求参与对应操作。
具体而言:
- 传统的
**__xxx**系列 in-warp API: 通常只对执行该指令时物理上处于 Active 状态的 Lanes 进行操作,而这些 Lanes 不一定与程序逻辑上期望参与操作的集合一致。
**__syncwarp(mask)**: 提供显式的 Warp-Level 同步,但不保证同步之后的所有 Lanes 会在后续指令中始终保持 Lockstep。 例如:
__syncwarp(0x0000FFFF);
auto foo = __activemask();
CUDA 不保证 foo 一定等于 0x0000FFFF,因为 Lanes 在离开同步点后,仍然可能以不同的执行进度继续向前推进。
不同控制流位置之间的同步
Post-Volta 还带来了一种以前难以实现的使用方式(注意, 似乎在后续的硬件废弃该特性):
允许位于不同控制流位置的 Sync 指令尝试同步同一个 Warp 内的 Threads。
按照这种同步模型,需要满足以下条件:
- 参与同一次同步的所有 Threads 使用相同类型的同步指令。例如,
__syncwarp不能与__shfl_sync相互同步。 - 参与同一次同步的调用使用相同的 Mask 值。
- 如果
lane i参与该同步调用,那么 Mask 中必须包含lane i对应的 Bit。 - Mask 指定的所有 Lanes 都必须到达对应的 Sync 调用。
例如:
if (cond) {
    __syncwarp(0xFFFFFFFF);  // 0
    Foo();
} else {
    __syncwarp(0xFFFFFFFF);  // 1
    Bar();
}
按照上述模型,两个不同位置的 __syncwarp 指令可以尝试完成同一次同步。
其可能的执行过程大致如下:
- 第一次 Issue
__syncwarp时,可能执行的是位置0,也可能是位置1。 - 硬件将
0xFFFFFFFF写入 Warp Sync Register,并清除已经到达同步点的 Lanes 所对应的 Bits。 - 随着后续 Lanes 到达各自的 Sync 指令,不断清除 Sync Register 中对应的 Bits。
- 当 Mask 中所有 Bits 都被清除后,说明所有参与同步的 Lanes 都已经到达同步点,可以继续执行后续代码。
- 此时:
cond对应的 Lanes,其 PC 大概率指向Foo()。~cond对应的 Lanes,其 PC 大概率指向Bar()。##